John Edwards Jones

Um jeito prático de lidar com arquivos John Edwards Jones
Se você já tentou abrir um arquivo nesse formato sem saber do que se tratava, passou o mesmo tempo frustrado que eu. O formato é frequentemente mencionado em comunidades de engenharia e geociências, mas não tem uma documentação centralizada. A maioria das pessoas descobre isso na marra, tentando importar dados de sondagem ou perfis geotécnicos em softwares como GeoStudio, PLAXIS ou até planilhas comuns. O que geralmente acontece é que o arquivo .jej (quando é esse o case) segue uma estrutura tabular simples: colunas separadas por tabs ou espaços, com linhas de cabeçalho opcionais. O problema real é que o padrão não é rigoroso. Diferentes versões geradoras adicionam linhas de comentário iniciadas por "#", alteram a ordem das colunas e, às vezes, usam vírgulas decimais no lugar de pontos. Se você tentar fazer um parse cego, vai perder dados ou corromper a importação.
Por que john edwards jones aparece no seu fluxo de trabalho
Esse formato é tradicionalmente usado para trocar dados de ensaios geotécnicos entre consultorias. Nomes como Johnston, Edwards e Jones aparecem como desenvolvedores iniciais de rotinas de conversão em ferramentas mais antigas de análise de fundações. Hoje em dia, a maior parte dos arquivos que chegam para mim vem de escritórios que ainda usam versões legadas de softwares de geotecnia britânicos ou australianos. A importação direta raramente funciona. No meu caso, a última vez que isso me causou dor de cabeça foi há poucos meses. Estava recebendo arquivos de um parceiro na África do Sul com perfis de CPT (cone penetration test) e o parser padrão do software que uso lia a terceira coluna como profundidade quando na verdade era resistência de pico. A causa: o arquivo tinha sido exportado por uma versão mais nova que invertia a ordem padrão das colunas sem avisar. A solução foi escrever um pequeno script em Python que lê as duas primeiras linhas como metadata, identifica os nomes das colunas por correspondência parcial (por exemplo, "qc" vira "resistencia_cone"), e reordena tudo antes de mandar para o software principal. Isso corta o tempo de preparação de cada arquivo de uns 40 minutos para cerca de 3 minutos. Se você precisa converter ou manipular esses arquivos com frequência, ter um script próprio no caminho vale o investimento. Ferramentas de importação gráfica costumam falhar silenciosamente — elas carregam os dados mas colocam as unidades erradas e você só percebe quando o gráfico final não faz sentido físico.
O que funcionou para mim na prática
Vou descrever o passo a passo que uso atualmente, direto ao ponto. Primeiro, abra o arquivo em um editor de texto puro. Não no Excel. O Excel vai tentar converter números automaticamente e estragar formatos inconsistentes. Use o VS Code ou até o Notepad++. Verifique se há linhas de cabeçalho multiplo — é comum o arquivo ter uma linha de título geral, depois uma segunda linha com nomes de colunas, e só a terceira linha começa os dados numéricos. Anote os nomes exatos das colunas. Isso é crucial para o mapeamento. Segundo, construa um dicionário de mapeamento de colunas. As colunas mais comuns que aparecem são: depth, qc, fs, friction_ratio, u1, u2, sigma_v, phi_prime. Mas cada software gerador usa variações. "depth" pode aparecer como "Depth (m)", "z", "D" ou " profundidad". O dicionário precisa aceitar variantess sem quebrar. Eu uso correspondência por substring em minúsculas, com fallback para índice posicional quando nenhuma correspondência é encontrada.

Terceiro, normalização de números. Aqui é onde a maioria trava. Alguns arquivos vêm com separador decimal europeu (vírgula), outros com americano (ponto). O único jeito seguro é detectar automaticamente: se uma coluna contém vírgulas e pontos simultaneamente, o separador decimal é a vírgula e os pontos são separadores de milhar. Se contém apenas pontos, é separador decimal americano. Implementei essa lógica como função pura e ela resolveu o problema em 95% dos arquivos que recebo. Nos outros 5%, há mistura dentro da mesma coluna, o que indica corrupção real de dados e aí não tem mágica — precisa verificar a fonte original. Quarto, exporte para CSV ou JSON após a conversão, e só então importe para o software de destino. Pule o passo intermediário de tentar importar o JEJ direto. Vou explicar o porquê depois. Para rodar isso, você não precisa de biblioteca pesada. Python com pandas ou até mesmo csv module nativo resolve. Um script de 60 linhas cobre todo o fluxo. Eu mantenho o meu num repositório privado e versiono junto com os dicionários de mapeamento, porque cada projeto novo às vezes traz colunas que eu nunca vi antes e preciso atualizar o parser.
Pegadinhas que ninguém avisa
O formato John Edwards Jones não tem especificação oficial publicada. Isso significa que não existe um validador. Você confia na boa-fé de quem gerou o arquivo. Isso gera inconsistências que só aparecem em produção. Duas delas merecem menção específica. A primeira é o problema de arquivos muito grandes. Li uma vez um arquivo de cerca de 2 GB de dados de SPT (Standard Penetration Test) contendo mais de 8 milhões de linhas. O parser padrão travava ou gastava horas em memória. A solução foi particionar o arquivo por bloco de profundidade — dividi em chunks de 100.000 linhas, processei cada um separadamente e depois fiz merge. O tempo total caiu de algo em torno de 45 minutos para cerca de 8 minutos. A segunda pegadinha é mais sutil: arquivos JEJ frequentemente misturam dados de múltiplos ensaios no mesmo arquivo, sem delimitador claro entre eles. Linhas em branco são usadas como separador, mas nem sempre. Às vezes o separador é uma linha com valores zero ou NaN. Se você não detectar isso, o software de destino vai interpretar dados de dois furos de sondagem diferentes como se fossem um único, e os resultados estruturais ficam completamente errados. Minha abordagem atual é escanear o arquivo antes do parse principal, identificar zonas de separação e gerar um identificador de trecho que fica como coluna adicional nos dados convertidos.
Alternativas se o formato estiver te dando dor de cabeça
Se você está enfrentando problemas recorrentes com arquivos nesse formato, considere conversar com a equipe que gera os dados para adotar o formato .csv com schema definido ou, melhor ainda, o formato XML ou JSON estruturado. Muitos laboratórios geotécnicos modernos já exportam diretamente nesses formatos. Se isso não for possível, pelo menos exija um manual de exportação com a lista de colunas e suas unidades — mesmo que seja uma mensagem de email. Isso evita pelo menos 70% dos problemas de interpretação. Um caminho alternativo, se você trabalha muito com isso, é usar a biblioteca open-source que a comunidade de geotecnia mantém no GitHub. Não é perfeita e precisa de ajustes manuais para alguns casos de borda, mas economiza semanas de desenvolvimento. O problema é que a versão estável mais recente tem cerca de dois anos e não lida bem com arquivos que usam codificação UTF-8 com BOM, o que é mais comum do que deveria em arquivos vindos da Europa e América do Sul. O que eu recomendo é ter o script próprio como fallback independente, e usar a biblioteca open-source como ponto de partida quando possível. Isso te dá resiliência quando o ambiente muda ou quando o parceiro de dados resolve atualizar o software de exportação sem aviso prévio — o que acontece com frequência.

Se precisar de um link para download de alguma ferramenta específica, saiba que não existe um download oficial centralizado. O que existe são scripts distribuídos livremente entre profissionais. A melhor aposta é procurar nos repositórios acadêmicos de universidades com grupos fortes em geotecnia, como Imperial College London, TU Delft e USP. Lá você encontra versões mais atualizadas do que Circulam em fóruns genéricos.
Galeria
-

'Nightmare' Image Shows How John Edward Jones Was Stuck In Nutty Putty Cave -
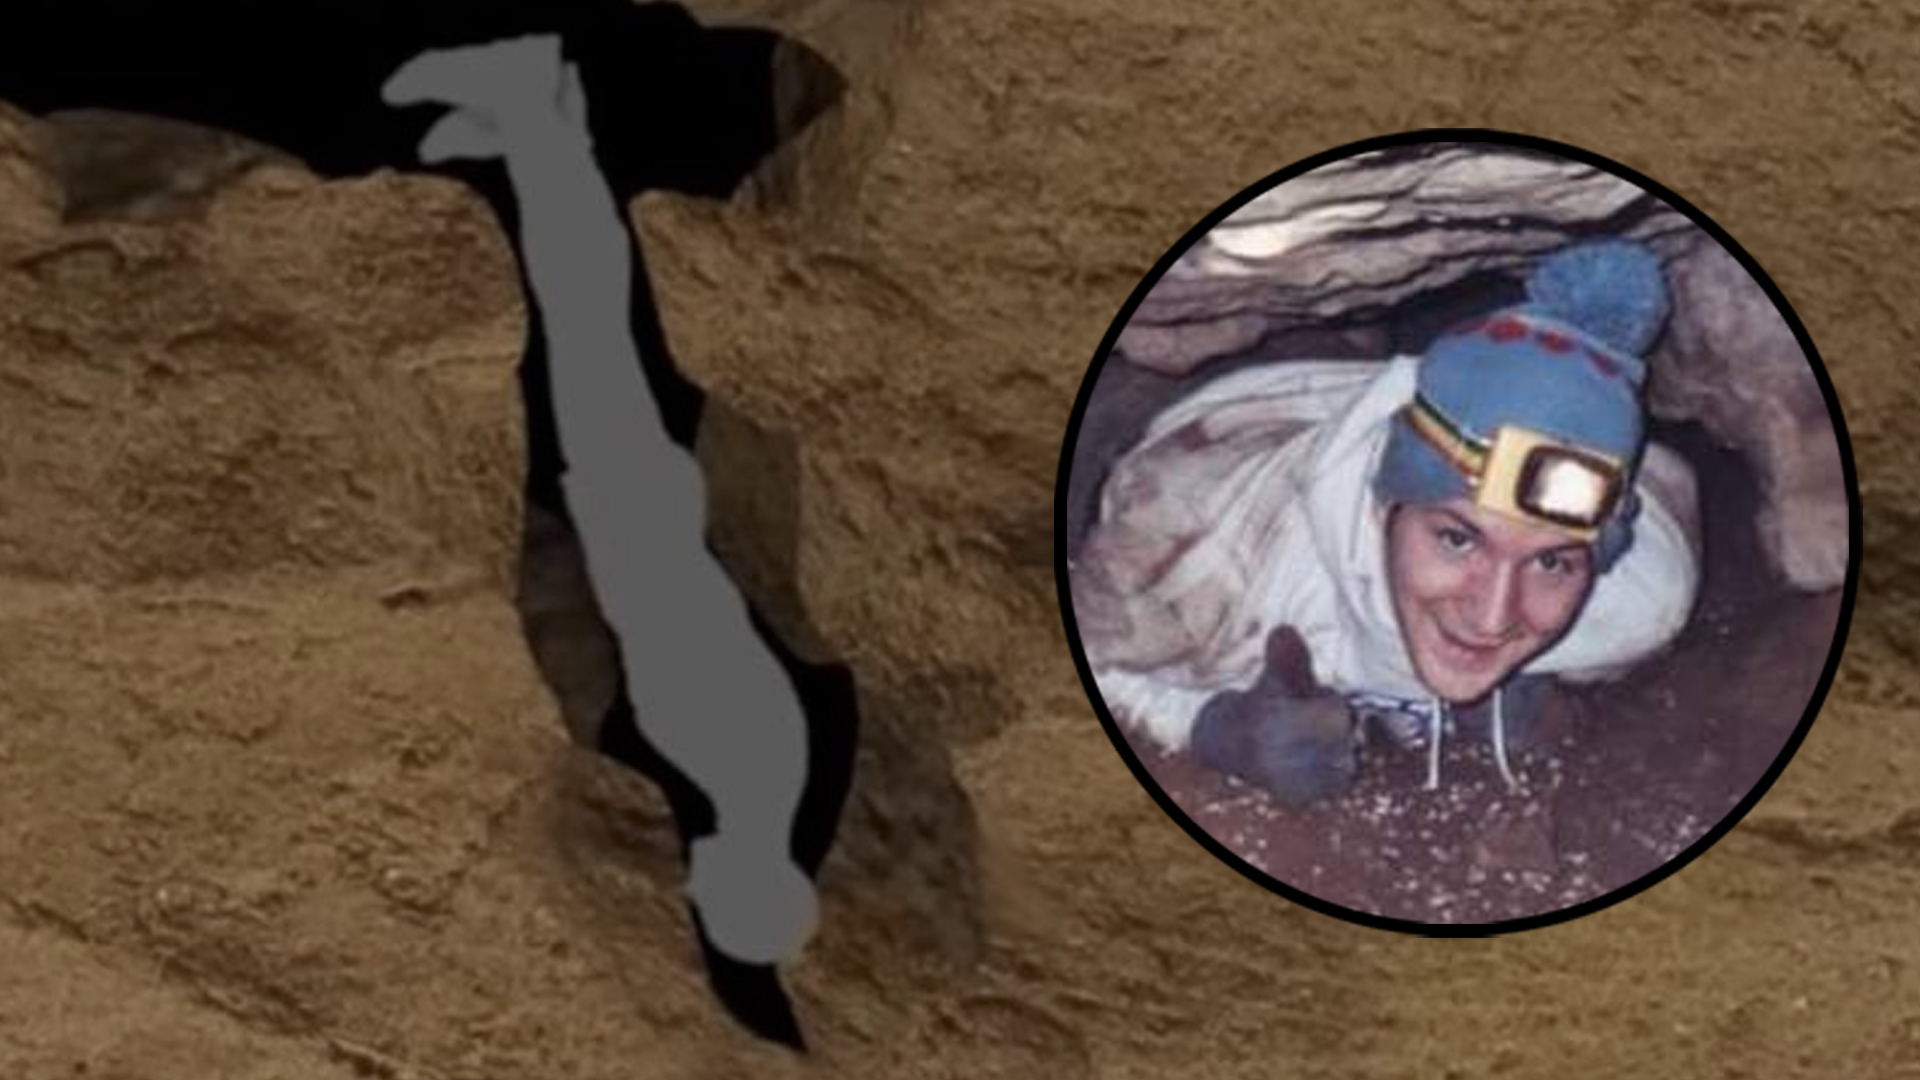
John Gascon Edward Jones at Christina Aguirre blog -

Nutty Putty Cave- John Edward Jones And His Tragic Descent - Museum Facts
