Regressão Logística
Um guia sem frescura sobre regressão logística
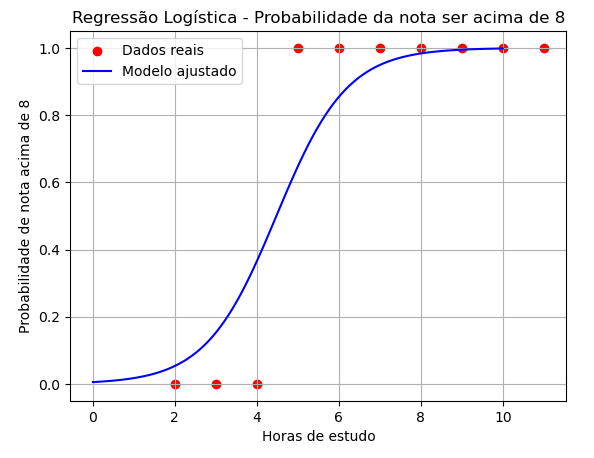
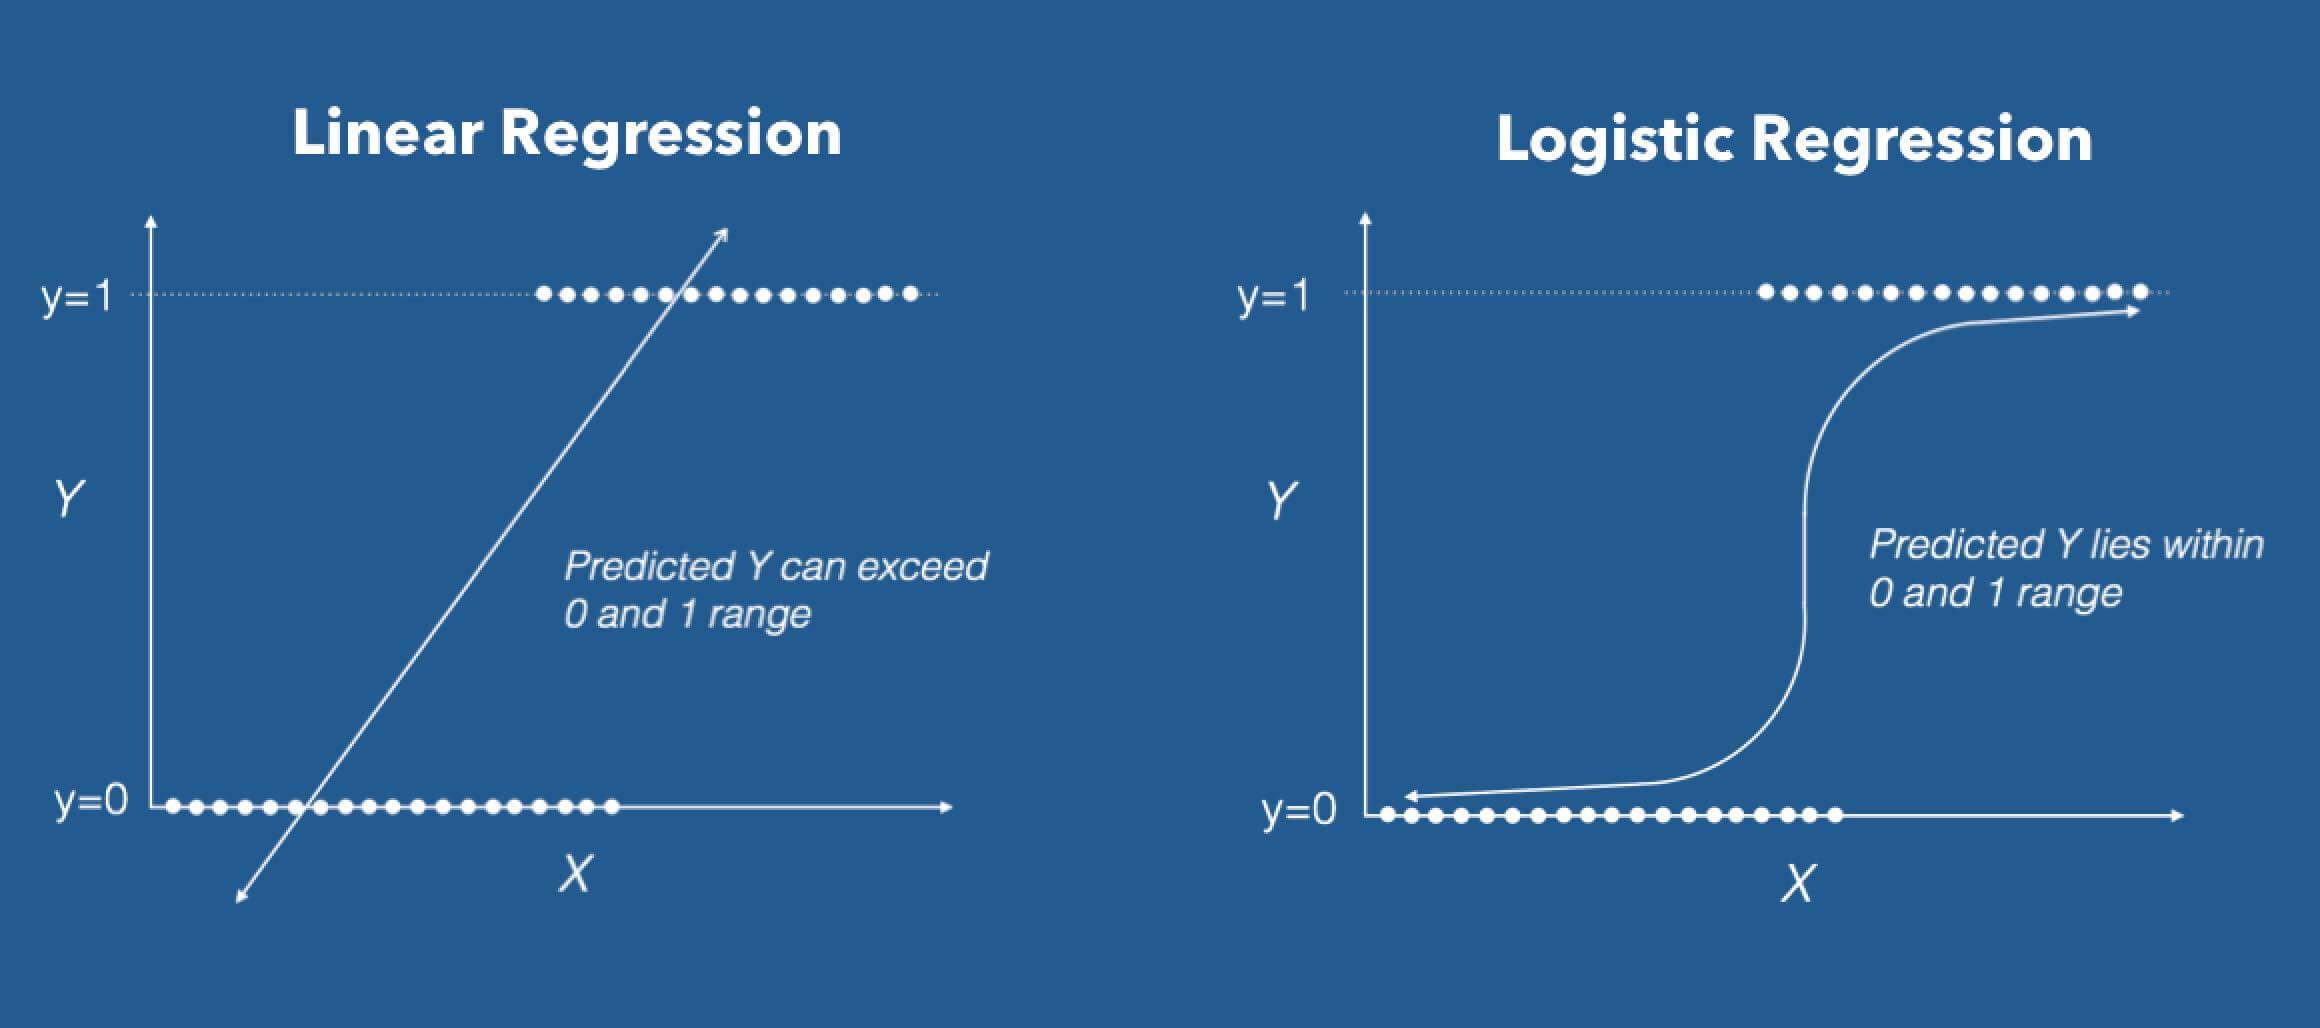
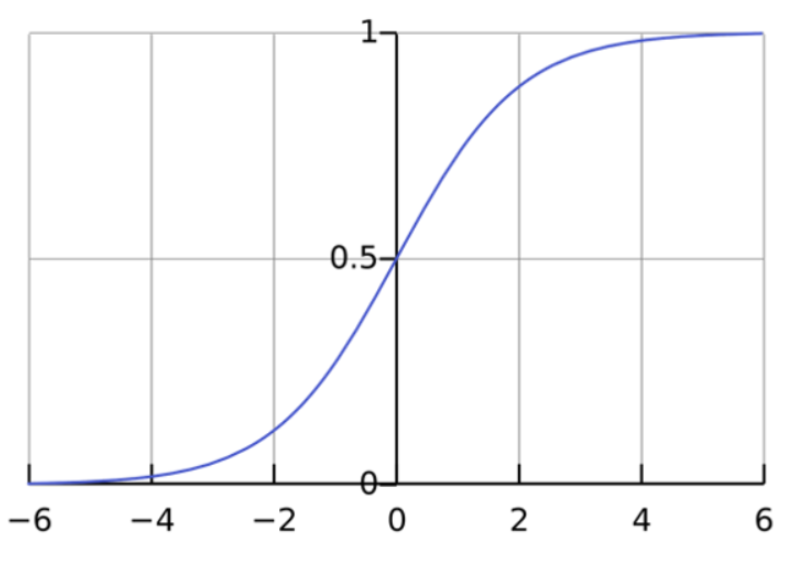
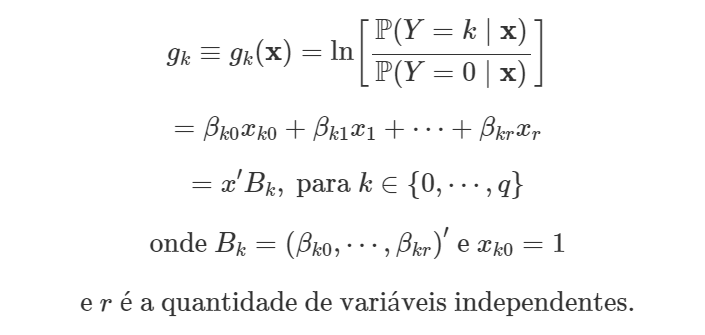
A regressão logística não é um modelo de classificação por acaso. O nome vem da parte da "logística", que se refere à função logística (sigmoide) que transforma um valor contínuo em uma probabilidade entre zero e um. É simples assim. Eu passei anos usando esse modelo em produção e ainda vejo gente confundir ele com uma bola de cristal para probabilidade. Vamos alinhar isso. Você tem um conjunto de features e quer prever se algo pertence a uma classe ou outra. Binário, geralmente: sim/não, 0/1, churn ou não-churn. A regressão logística encontra um hiperplano que separa as classes no espaço das features, mas ao invés de simplesmente decir "está de um lado ou de outro", ela passa o resultado bruto pela função sigmoide e te dá uma probabilidade. Esse é o diferencial dela em relação a uma SVM linear, por exemplo. O coeficiente de cada feature representa o quanto aquele atributo empurra o log-odds (logaritmo da razão entre probabilidade de ser positivo e probabilidade de ser negativo). Se o coeficiente é positivo, aumentar aquela feature aumenta a chance da classe positiva. Se é negativo, acontece o contrário. Intercepto é o valor base quando todas as features são zero.
Como treinar um modelo real
Aqui vai o passo a passo sem enrolação. Primeiro, normalize ou padronize suas features. A regressão logística é sensível à escala, especialmente se você usar regularização. Escala diferente entre features pode fazer com que o modelo punha mais certas variáveis injustamente durante o L1 ou L2. Use StandardScaler do scikit-learn, ouMinMaxScaler se tiver outliers agressivos. Depois, divida seus dados em treino e teste. Estratififique se a classe for desbalanceada, senão você pode acabar com um conjunto de treino que tem 99% de uma classe e o modelo aprende a prever tudo como majoritária. Escolha o solver. Para dados tabulares comuns, o lbfgs é rápido e confiável. Se tiver muitas features (dezenas de milhares), experimente o sag ou shotgun. Para regularização L1 (que gera esparsidade nos coeficientes, ou seja, seleciona features automaticamente), use o liblinear ou saga. O saga é particularmente útil quando você precisa de L1 com mais de uma milhar de amostras.
Treine com cross-validation para ajustar hiperparâmetros como C (inverso da força da regularização). Um C muito grande significa pouca regularização e risco de overfitting. Um C muito pequeno suprime todas as features e o modelo vira um palpite basico. Geralmente varro C em [-3, -2, -1, 0, 1, 2, 3] usando GridSearchCV com 5 folds. Isso leva de 5 a 15 minutos dependendo do tamanho dos dados.

O problema que ninguém conta
Separo esse ponto porque é onde eu me queimei. Trabalhei em um projeto de risco de crédito onde a regressão logística estava sendo usada para prever inadimplência. A taxa de base era algo como 3% de inadimplentes. O modelo entregava AUC de 0,82, o que parecia ótimo. Mas quando fui calibrar para produção, percebi que as probabilidades estavam completamente deslocadas. O modelo prevía inadimplência com probabilidade média de 0,12 para alguns clientes que eram claramente baixíssimo risco. A curva de calibration mostrava um desvio absurdo. A solução foi aplicar isotonic regression ou Platt scaling no conjunto de validação após o treino. Isotonic preserve a monotonicidade sem assumir uma forma funcional específica, mas exige mais dados para calibrar. Platt scaling é mais leve e assume uma função sigmoide sobre as saídas do modelo. Para o meu caso, isotonic funcionou melhor porque o desvio não era uniforme em todo o range de probabilidades. Houve uma região onde o modelo sistematicamente superestimava e outra onde subestimava. Calibration com isotonic corrigiu isso em cerca de 10 minutos adicionais no pipeline. Se você não calibrar, suas probabilidades são inúteis para tomada de decisão. Pode parecer que está otimizado, mas na prática você está tomando decisões baseadas em números que não refletem a realidade.
Duas verdades contra-intuitivas
A primeira: mais features nem sempre melhoram regressão logística. Eu já vi projetos onde adicionar features de perfil demográfico piorava a performance. O motivo é que features correlacionadas ou ruidosas aumentam a variância do estimador, especialmente com regularização fraca. Use seleção de features baseada em importância dos coeficientes ou, melhor ainda, test em out-of-sample. Um modelo com 20 features bem escolhidas frequentemente vence um com 200features bagunçadas. A segunda: a regressão logística assume linearidade no log-odds. Isso significa que a relação entre cada feature e o logaritmo das chances é linear. Na prática, você precisa verificar isso. Crie splines ou transformações polinomiais para features que parecem ter relação não-linear com o target. Uma variável como "idade" pode ter efeito quadrático: jovens e idosos têm risco diferente, mas adultos no meio têm risco menor. Sem capturar isso, o modelo perde poder preditivo sem motivo.
Quando não usar regressão logística
Vou ser direto aqui. Se seus dados são sequenciais, temporais ou têm estrutura espacial complexa, essa não é a ferramenta certa. Modelos como LSTM, Transformer ou Gaussian Processes fazem muito melhor esse trabalho. Se você tem milhões de instâncias com relações altamente não-lineares, gradient boosting (XGBoost, LightGBM) ou redes neurais vão superar logisticamente regressão com facilidade. A regressão logística brilha em datasets tabulares a médios, onde interpretabilidade importa tanto quanto performance, e onde as suposições de linearidade no log-odds se sustentam razoavelmente. Também não funcionam bem com features altamente esparsas e categóricas sem encoding adequado. One-hot encoding de variáveis com milhares de categorias pode explodir a dimensionalidade e destruir a eficiência do solver. Nesses casos, embedding ou target encoding são alternativas muito mais prácticas.

Código prático em cinco linhas
Aqui está o mínimo que você precisa rodar: from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split, GridSearchCV scale = StandardScaler()
X_train_s = scale.fit_transform(X_train)
X_test_s = scale.transform(X_test)
model = LogisticRegression(solver='lbfgs', max_iter=1000)
param_grid = {'C': [0.01, 0.1, 1, 10, 100]}
grid = GridSearchCV(model, param_grid, cv=5, scoring='roc_auc')
grid.fit(X_train_s, y_train)
print(grid.best_params_)
A partir daí, use grid.predict_proba(X_test_s) para obter probabilidades calibradas e grid.score() para ver AUC no teste. Se precisar de seleção de features com L1, troque solver por 'saga' e C por valores menores, como [0.001, 0.01, 0.1]. É isso. Regressão logística é uma ferramenta honesta. Ela não vai resolver todos os seus problemas, mas quando se encaixa, é rápida, interpretável e robusta o suficiente para rodar em produção sem drama. Não force onde não cabe. Use onde funciona. E sempre calibra as probabilidades antes de confiar nelas.
Galeria
-
Regressão Logística: Conceitos Essenciais e Modelo - ESTATSITE.COM.BR -
O que é regressão logística? – Explicação sobre o modelo de regressão ... -
Regressão Logística Multinomial - Statplace
